Comparison
Gemini 4 Argon vs Qwen3.8-Flash-Next
People have published 9 builds with Gemini 4 Argon and 139 with Qwen3.8-Flash-Next, overlapping in 2 use cases. Qwen3.8-Flash-Next has more coding, agents.
Gemini 4 Argon
Google DeepMind's first Gemini 4 frontier model, aimed at long-horizon coding, legal/finance knowledge work and cyber defense. 1M-token output limit. Initially gated to Fairwind Program cyber defenders; intro API price $2/$10 per 1M tokens.
- 9
- Entries
- 9
- Creators
- X, YouTube, Web
- Top source
Qwen3.8-Flash-Next
Open-weight 125B-parameter multimodal MoE (about 6B active, plus a 51B n-gram embedding table) from Alibaba's Qwen team, an early preview of the Qwen4 architecture. Its n-gram table can sit in system RAM or on SSD, which let community engines such as Strata run it on gaming PCs and Macs.
- 139
- Entries
- 131
- Creators
- GitHub, Reddit, X
- Top source
Same use case, side by side
Use caseGemini 4 ArgonQwen3.8-Flash-Next
Coding
Qwen3.8-Flash-Next · 4 entriesGVS5H: five Qwen3.8 models matching a frontier model on LiveCodeBench Hard
Agents
Top builds with Gemini 4 Argon
- 1Sundar Pichai's early look at Gemini 4 Argonon X:Sundar Pichai· 25.9K likes
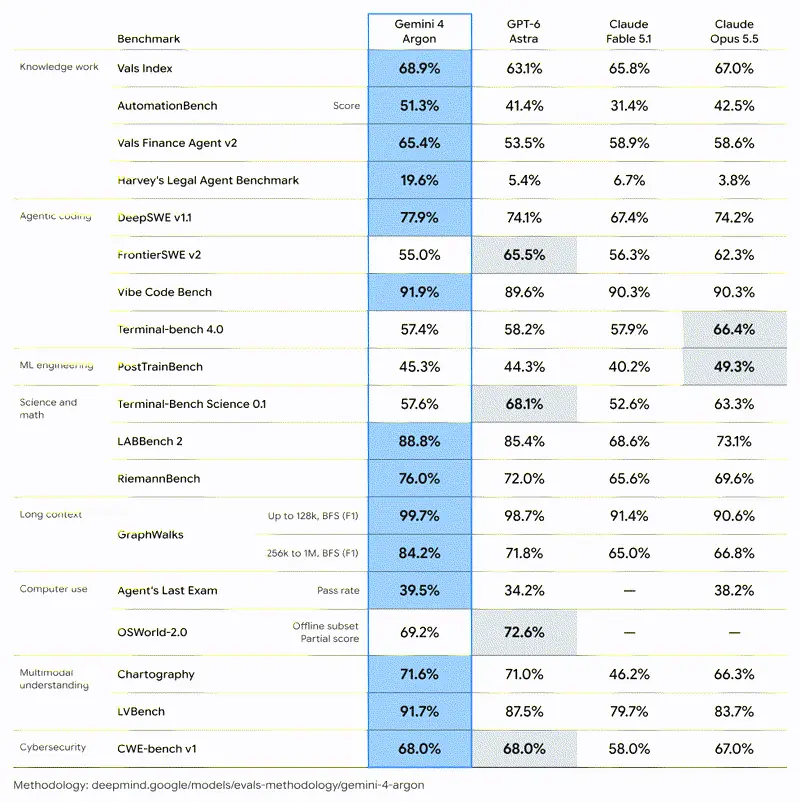
- 2Greg Isenberg's takeaways: quantum circuits, memory savingson X:GREG ISENBERG· 2.2K likesx.com
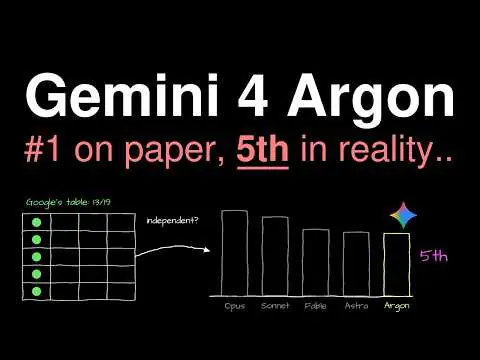
- 3Gemini 4 Argon Analysis: Massive Power, Major Limitationson YouTube:Bruno Vega· 46.9K views
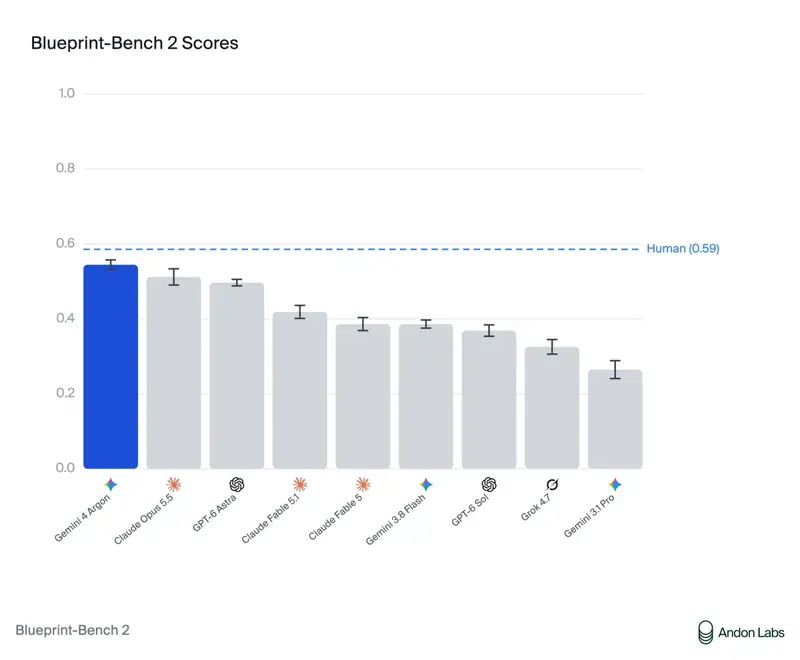
- 4Andon Labs: Argon tops Blueprint-Bench 2 floorplan benchmarkon X:Andon Labs· 1.2K likes
- 5AICodeKing: in-depth Argon benchmark analysison YouTube:AICodeKing· 29.5K views
Top builds with Qwen3.8-Flash-Next
- 1Strata: one-click engine for running the 125B Flash-Next on a gaming PCon GitHub:Niko1221· 16.8K stars
- 2Flash-Next on a single DGX Spark (TP=1)on GitHub:MiaAI-Lab· 594 stars
- 3Halogen: fastest Flash-Next server for AMD Strix Haloon GitHub:peonist-ai· 876 stars
- 4GVS5H: five Qwen3.8 models matching a frontier model on LiveCodeBench Hardon GitHub:slee-persis· 736 stars
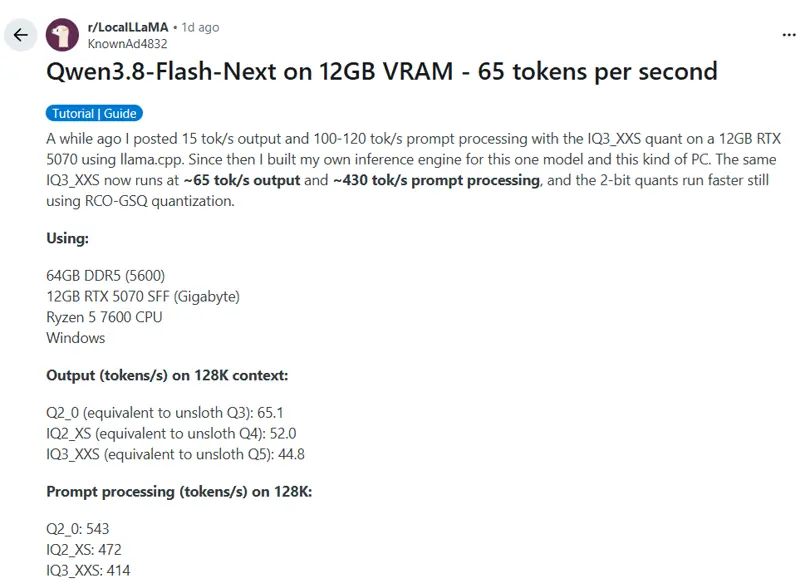
- 5From 15 tps on llama.cpp to 65 tps with a home-built engineon X:David Hendrickson· 1.6K likes